南桥
外部 I/O 设备,是通过主板上的南桥(SouthBridge)芯片组,来控制和 CPU 之间的通信的。“南桥”芯片的名字很直观,一方面,它在主板上的位置,通常在主板的“南面”。另一方面,它的作用就是作为“桥”,来连接鼠标、键盘以及硬盘这些外部设备和 CPU 之间的通信。
cpu时钟
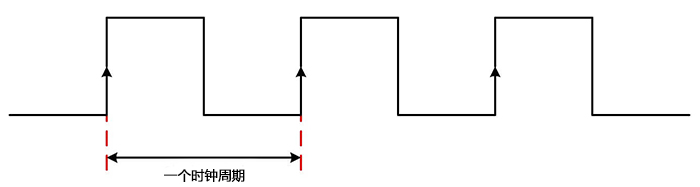
cpu内部的晶体振荡器每振一次就是一个时钟周期;
一个4Ghz的CPU其中4Ghz表示时钟频率;4Ghz表示每秒能处理40亿个脉冲信号(也可以理解为每秒钟能处理的简单指令数)
时钟周期时间=1/时钟频率
也就是CPU产生一个脉冲信号只需要0.25ns
cpu寄存器
一个程序的运行
cpu根据pc寄存器里的地址,从内存中把需要的指令读取到之林寄存器中执行,然后根据指令长度递增,开始顺序读取下一条指令.
一个程序的运行在内存中使连续保存的,也会一条条的按顺序加载
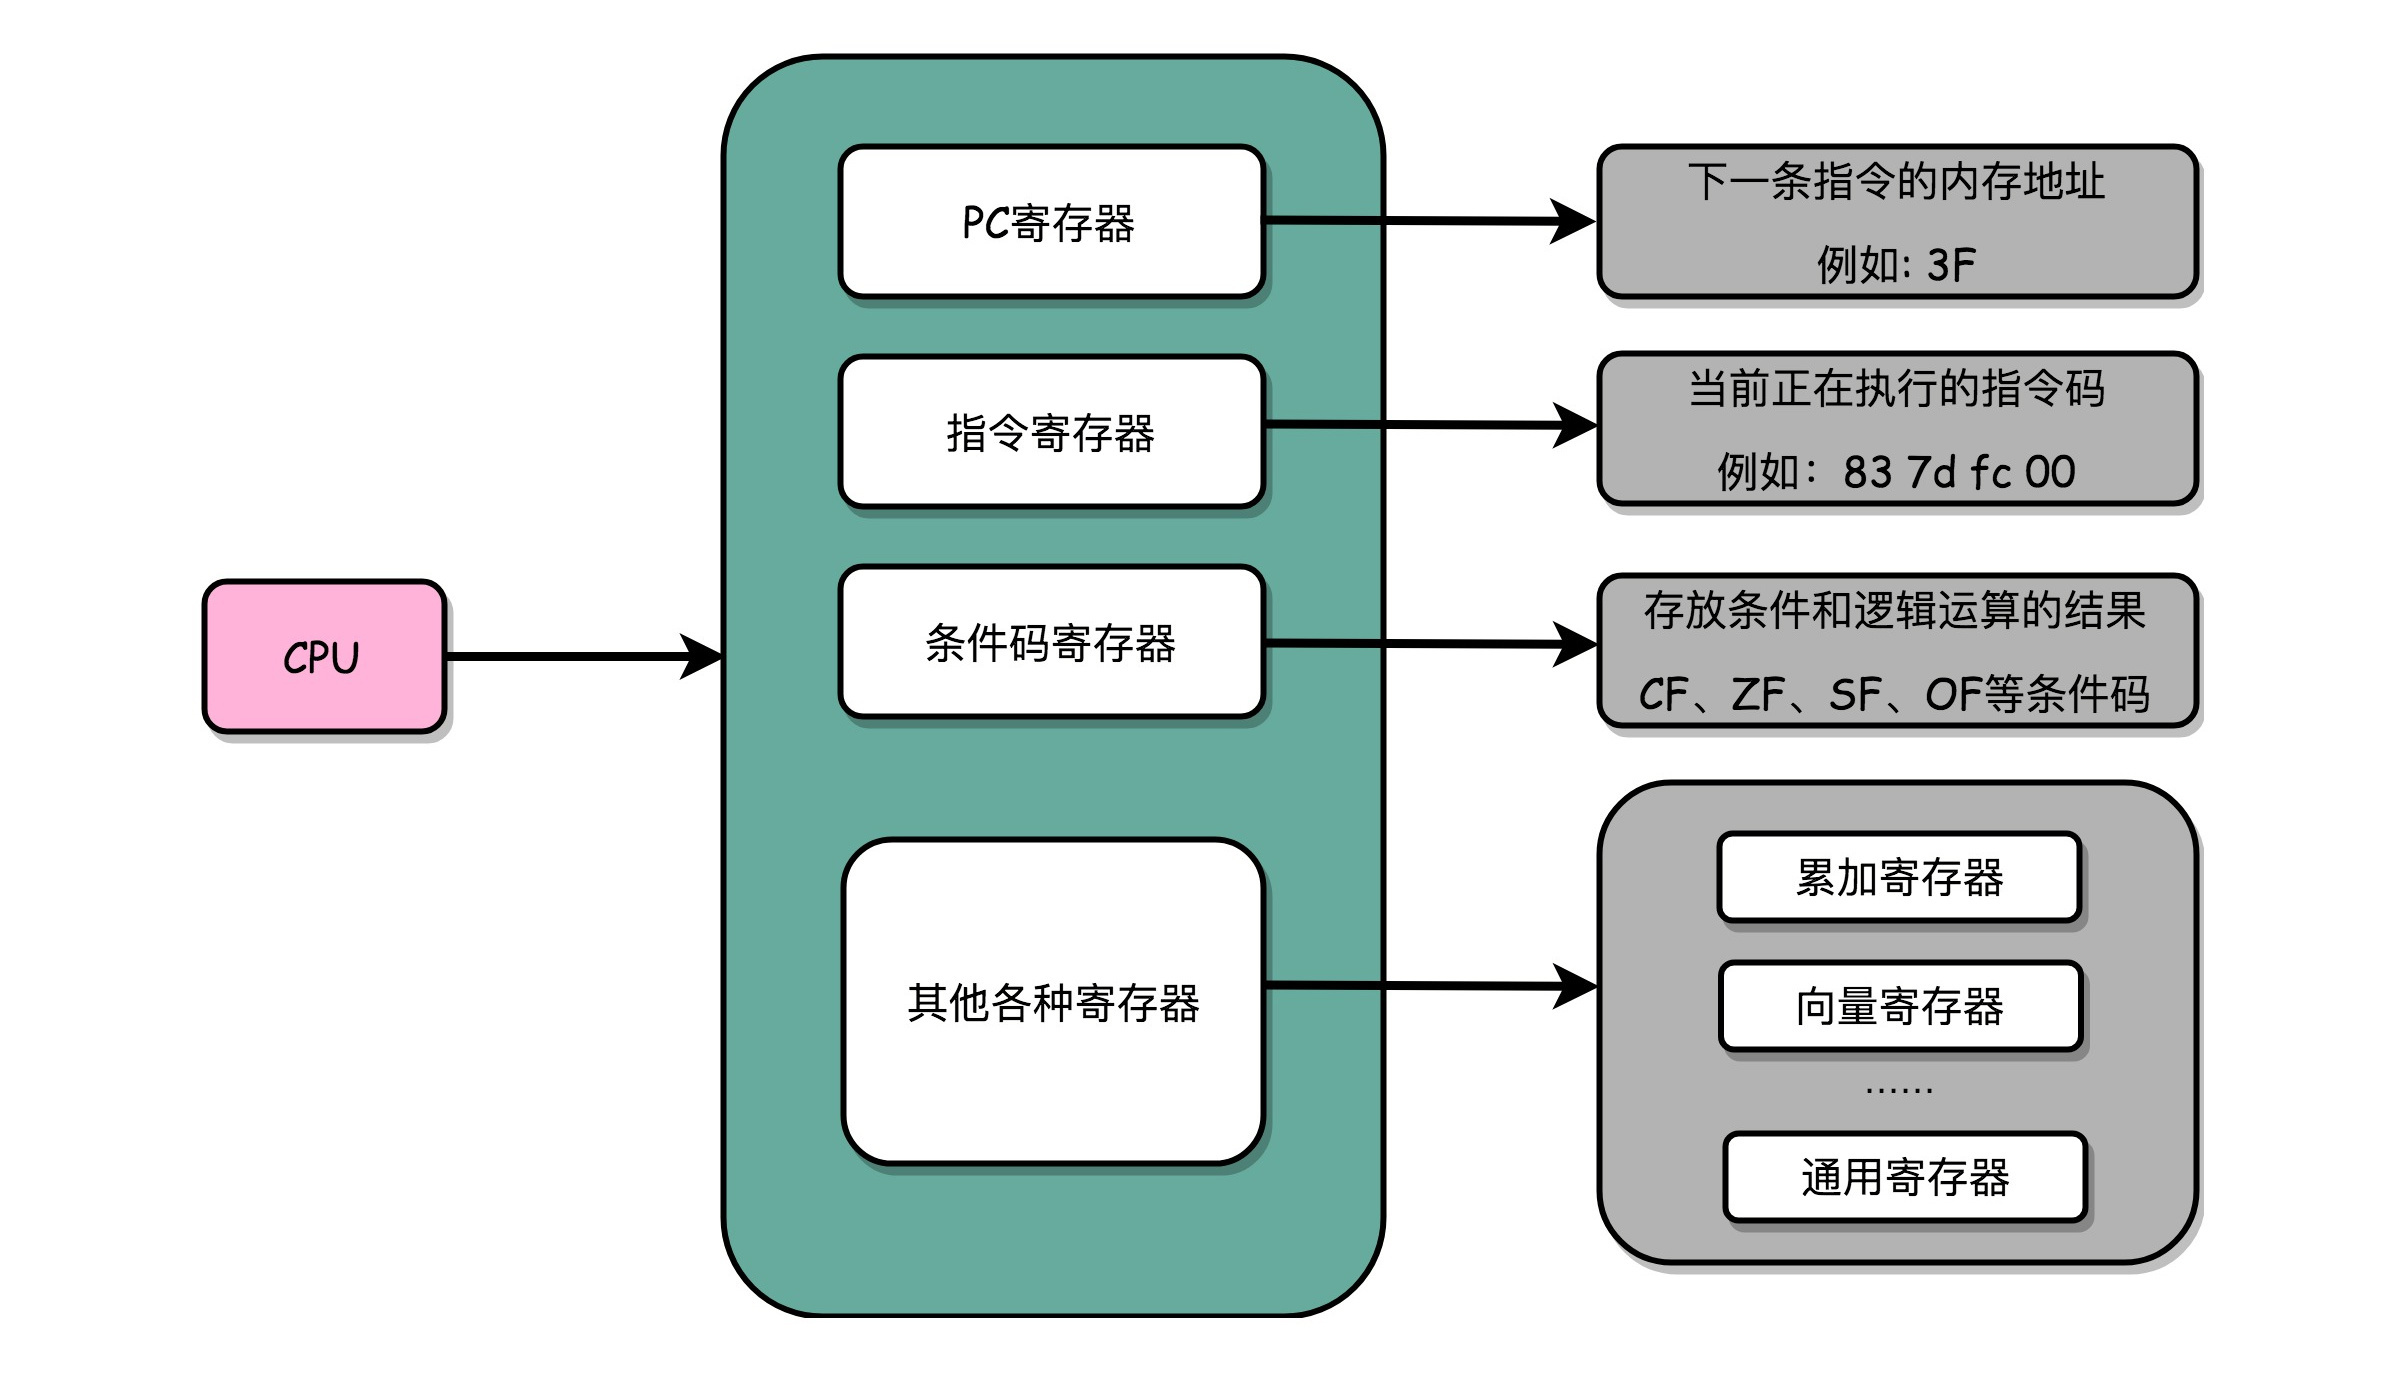
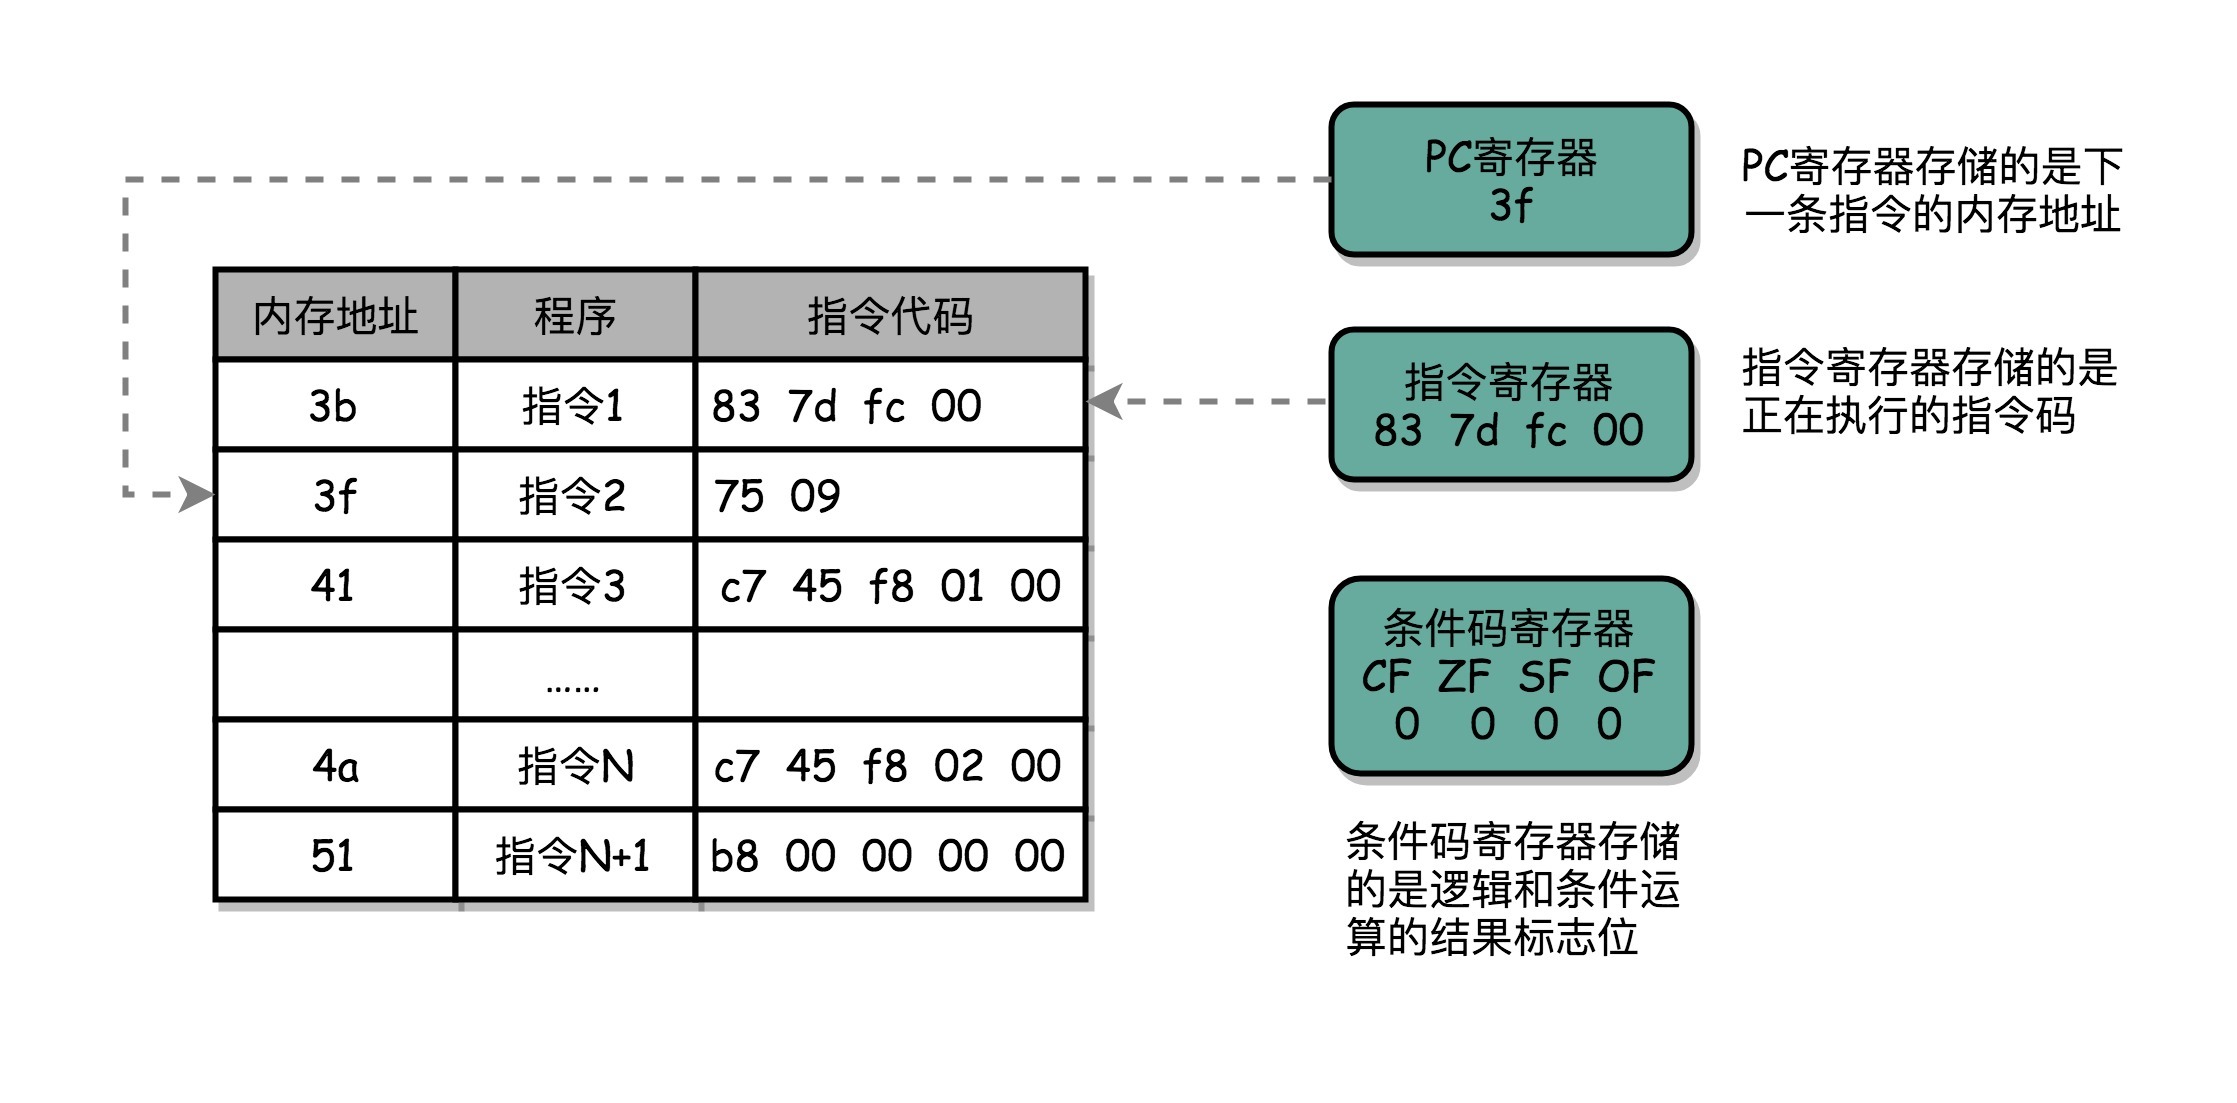
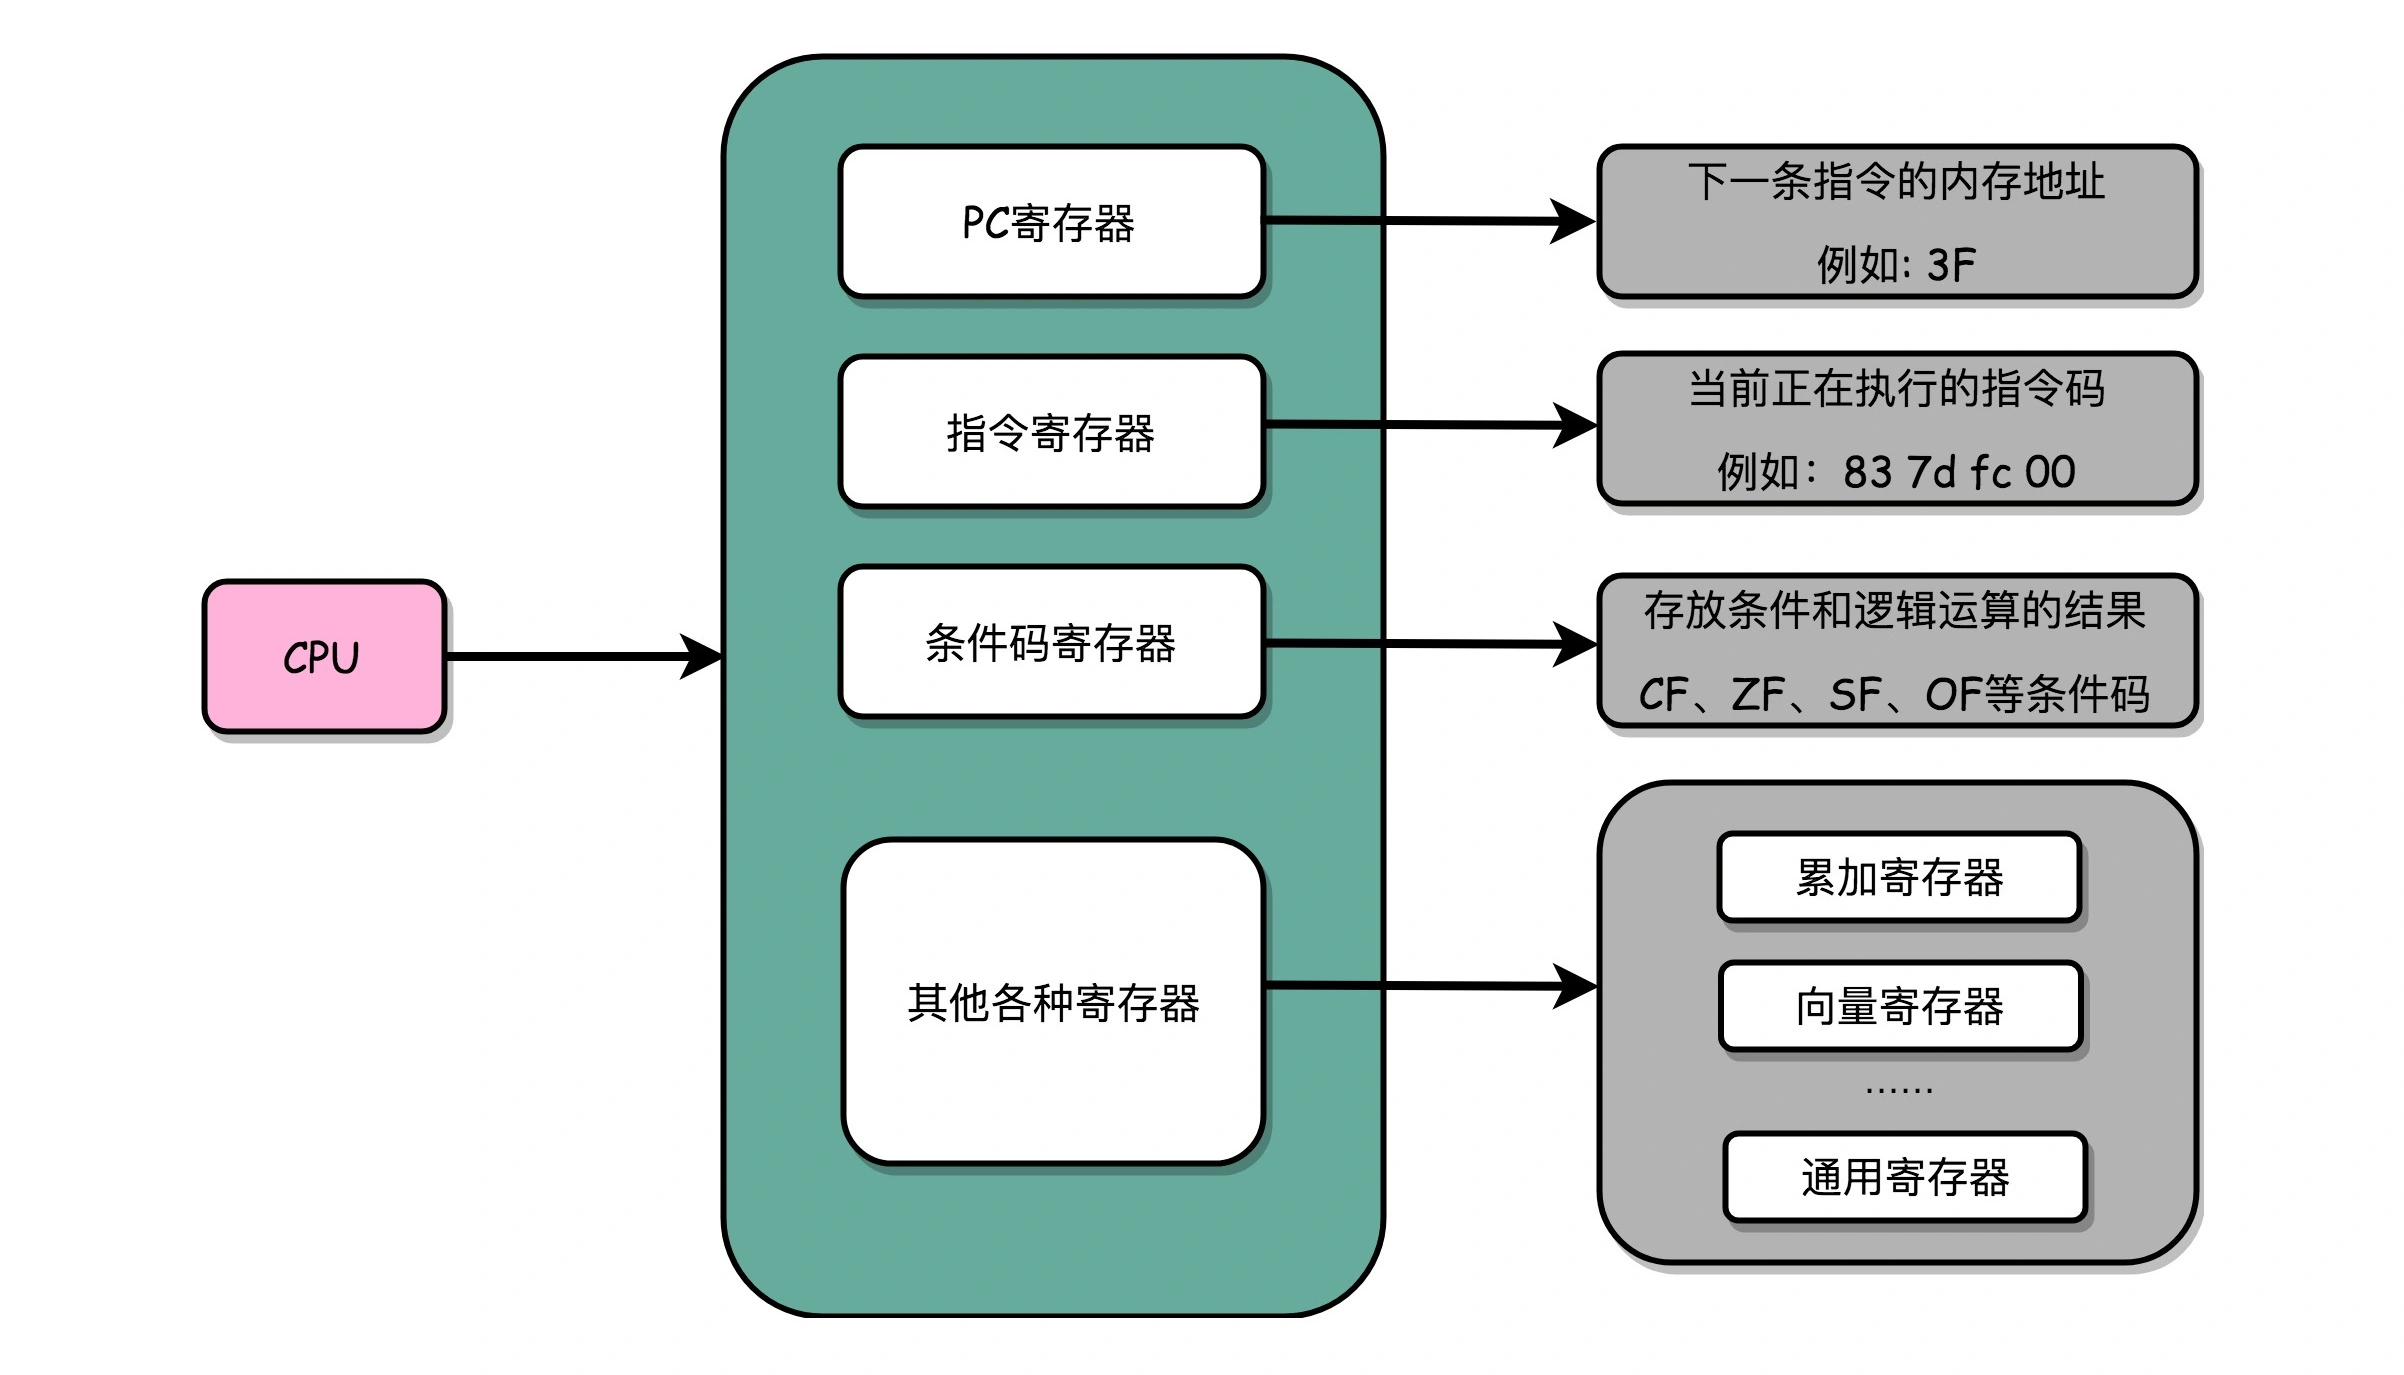
PC寄存器(Program Counter Register)也叫指令地址寄存器(instruction address register)
用来存储下一条需要执行的计算机指令的内存地址
指令寄存器(Instruction Register)
存放当前正在执行的指令
条件码寄存器(Status Register)
用一个一个的标记位(Flag),存放cpu进行算数或者逻辑运算的结果.
实例
// test.c


#include <time.h>
#include <stdlib.h>


int main()
{
  srand(time(NULL));
  int r = rand() % 2;
  int a = 10;
  if (r == 0)
  {
    a = 1;
  } else {
    a = 2;
  }
    if (r == 0)
  3b:   83 7d fc 00             cmp    DWORD PTR [rbp-0x4],0x0  ;[..0x4]代表r的地址,0x0是0的十六进制
  3f:   75 09                   jne    4a <main+0x4a>
    {
        a = 1;
  41:   c7 45 f8 01 00 00 00    mov    DWORD PTR [rbp-0x8],0x1  ;[..0x8]代表a的地址 ,0x1是1的十六进制
  48:   eb 07                   jmp    51 <main+0x51>
    }
    else
    {
        a = 2;
  4a:   c7 45 f8 02 00 00 00    mov    DWORD PTR [rbp-0x8],0x2
  51:   b8 00 00 00 00          mov    eax,0x0
    }
执行过程
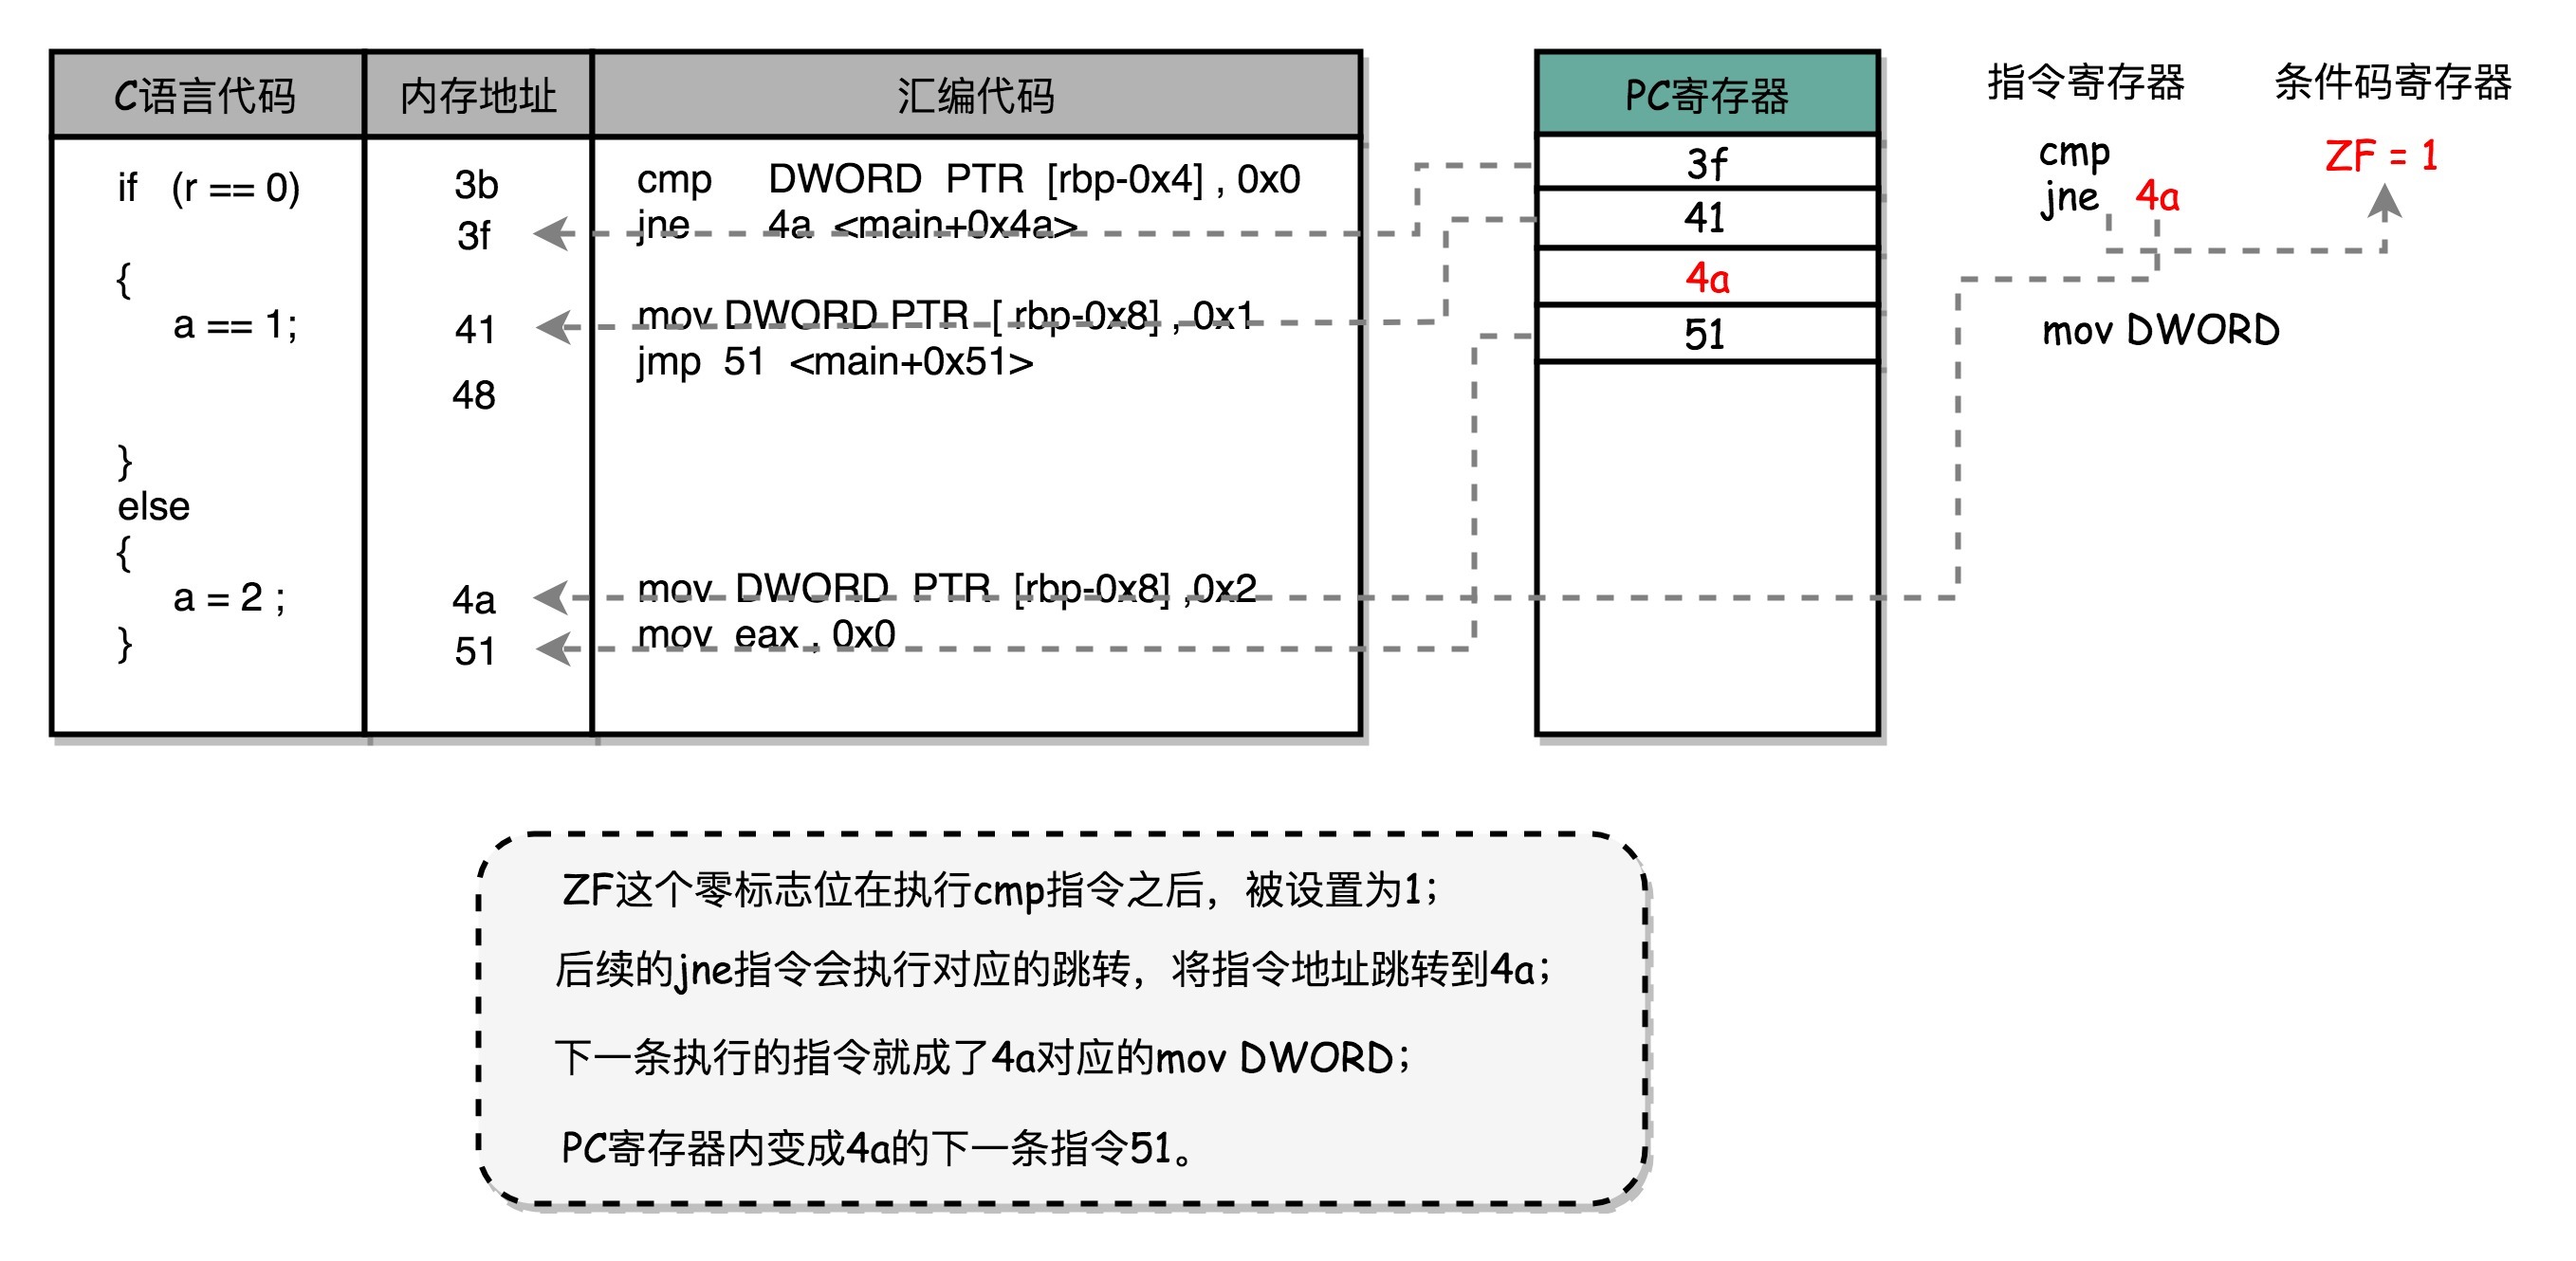
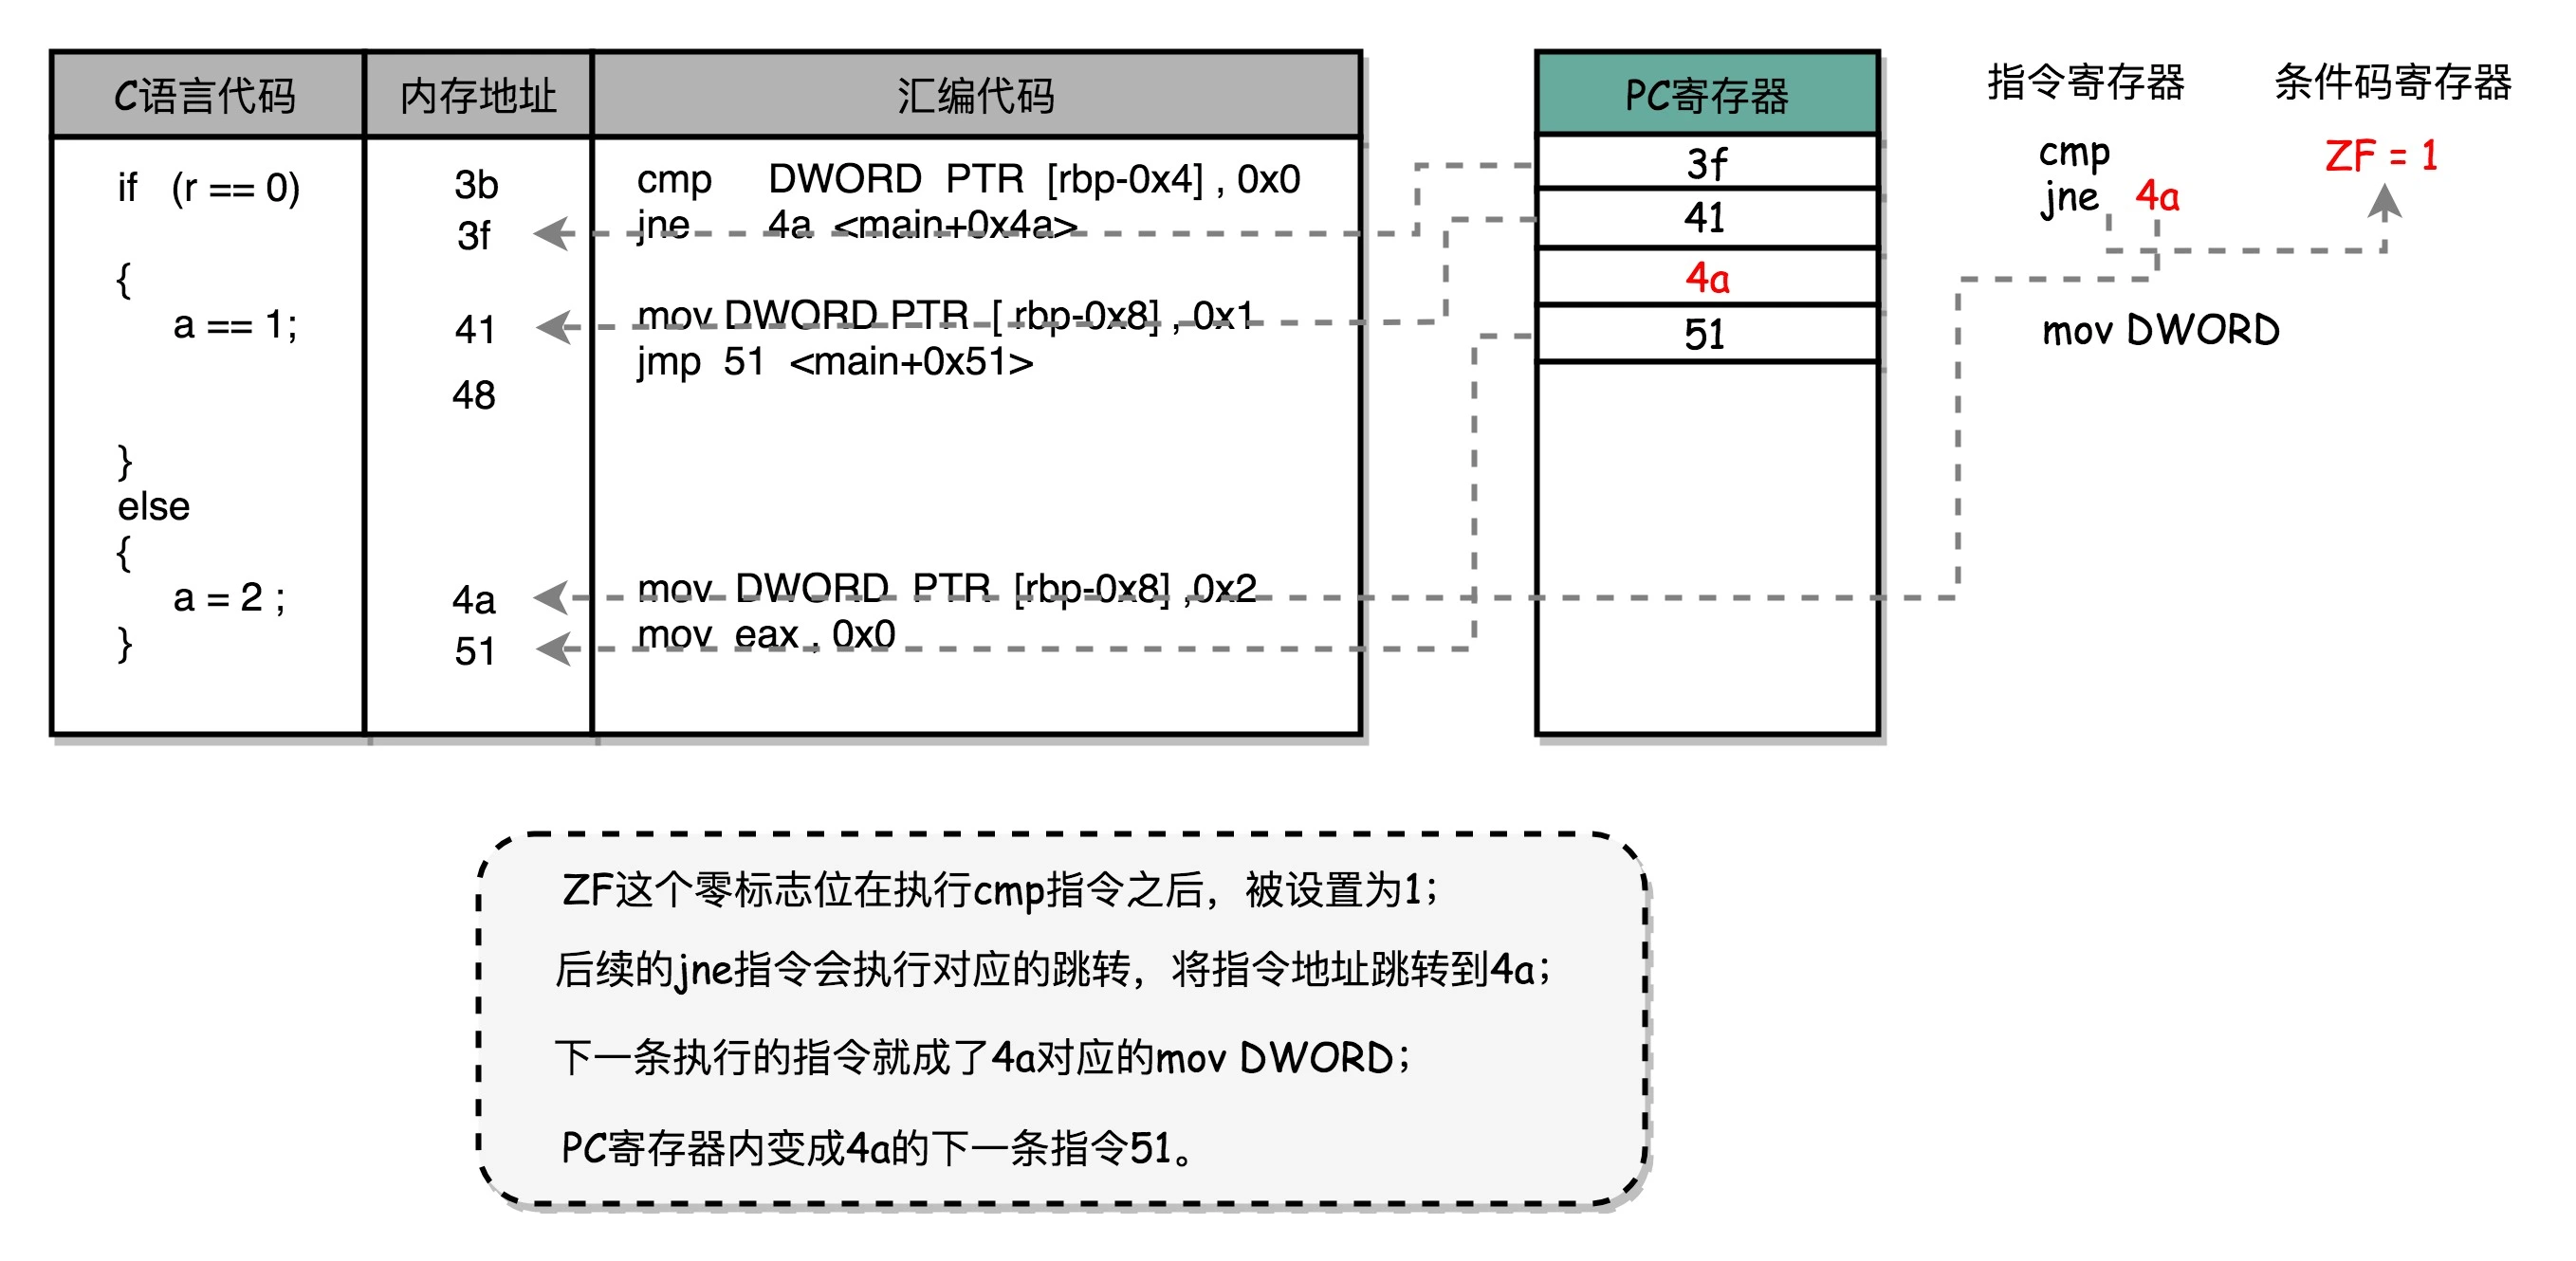
代码按顺序执行
cmp指令是比较前后两个操作数的值;
cmp比较的条件如果为True;也就是(r==0);那么条件码寄存器的其中一个标志:零标志条件码(ZF:Zero Flag) 的值就会设置1;如果结果为False;也就是(r!=0);ZF就会设置为0
下面的jne(jump if not equal) 表示如果ZF值为0;jne就会跳转到操作数4a的位置;
当跳转发生时;PC寄存器存的就是4a哪一行的地址;
跳转后指令寄存器中的值就是4a那一行里面的指令
c语言执行过程

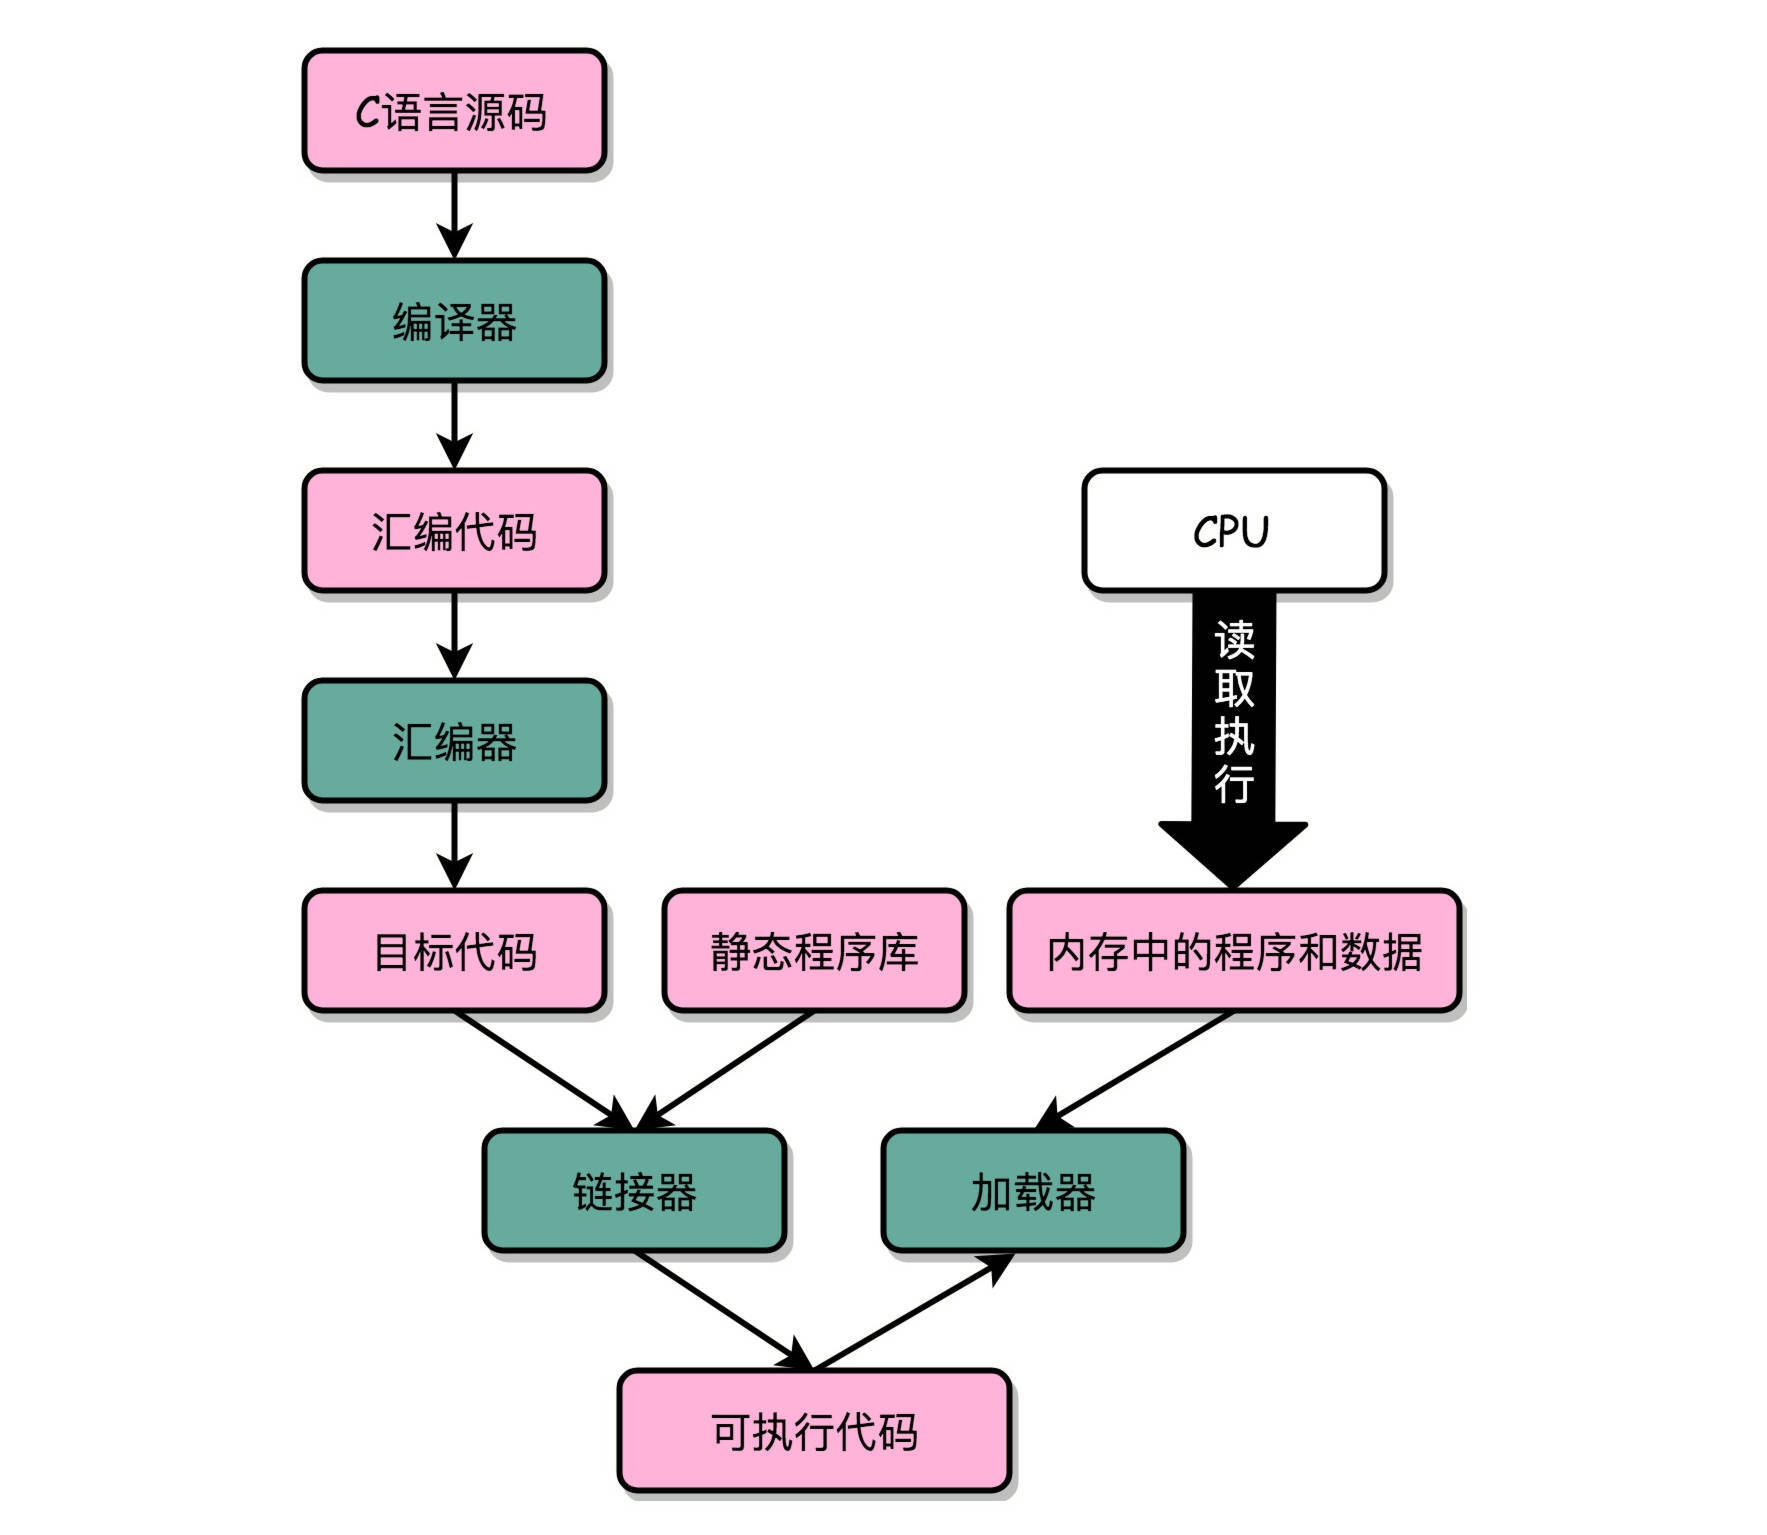
预处理器,编译器,汇编器和链接器一起构成了编译系统(compilation system)
预处理阶段
源程序.c的文件通过预处理器将有关头文件的信息直接插入到源程序中完成后的文件后缀为.i
编译阶段
.i文件通过编译器将源代码编译为汇编语言后缀为.s
汇编阶段
.s文件通过汇编器将.s文件翻译为机器语言指令后缀为.o(为一个二进制文件)
链接阶段
只有通过链接器(Linker)把多个目标文件以及调用的各种函数库链接起来,我们才能得到一个可执行文件。
.o文件通过链接器将文件内类似printf函数的printf.o二进制文件链接起来,得到一个可执行文件
gcc常用选项
-g 产生调试信息
-c  Compile and assemble, but do not link.
进程(process)
进程就是对正在运行的程序的一个抽象概念,计算机通常能同时运行多个进程,通过一种叫做上下文切换的方式
(context switch),上下文就是进程运行所需要的状态信息;上下文包括PC和寄存器文件的当前值,以及主存的内容
C语言代码-汇编代码-机器码执行过程
第一部分由编译→汇编→链接最终变为一个可执行文件
第二部分由装载器完成;装载器解析ELF文件,把对应的指令和数据装载到内存供CPU执行;
程序跳转
有三种寄存器有关于程序跳转
一个是 PC 寄存器(Program Counter Register),我们也叫指令地址寄存器(Instruction Address Register)。顾名思义,它就是用来存放下一条需要执行的计算机指令的内存地址。
第二个是指令寄存器(Instruction Register),用来存放当前正在执行的指令。
第三个是条件码寄存器(Status Register),用里面的一个一个标记位(Flag),存放 CPU 进行算术或者逻辑计算的结果。零标志条件码(对应的条件码是 ZF,Zero Flag) ,进位标志(CF,Carry Flag)、符号标志(SF,Sign Flag)以及溢出标志(OF,Overflow Flag),用在不同的判断条件下。
    if (r == 0)
  3b:   83 7d fc 00             cmp    DWORD PTR [rbp-0x4],0x0
  3f:   75 09                   jne    4a <main+0x4a>
    {
        a = 1;
  41:   c7 45 f8 01 00 00 00    mov    DWORD PTR [rbp-0x8],0x1
  48:   eb 07                   jmp    51 <main+0x51>
    }
    else
    {
        a = 2;
  4a:   c7 45 f8 02 00 00 00    mov    DWORD PTR [rbp-0x8],0x2
  51:   b8 00 00 00 00          mov    eax,0x0
    }
上面代码中if(r ==0 ) 被编译为 cmp 和 jne(jump if not equal) 两个指令,cmp用于比较,将比较结果放入条件码寄存器中
如if结果为true那么就把零标志条件为ZF设置为1,cmp执行完后PC寄存器自增,开始执行吓一跳jne指令,jne会查看ZF,如果为0(也就是上面的结果为Flase)就跳转到4a
ELF格式和链接:链接过程
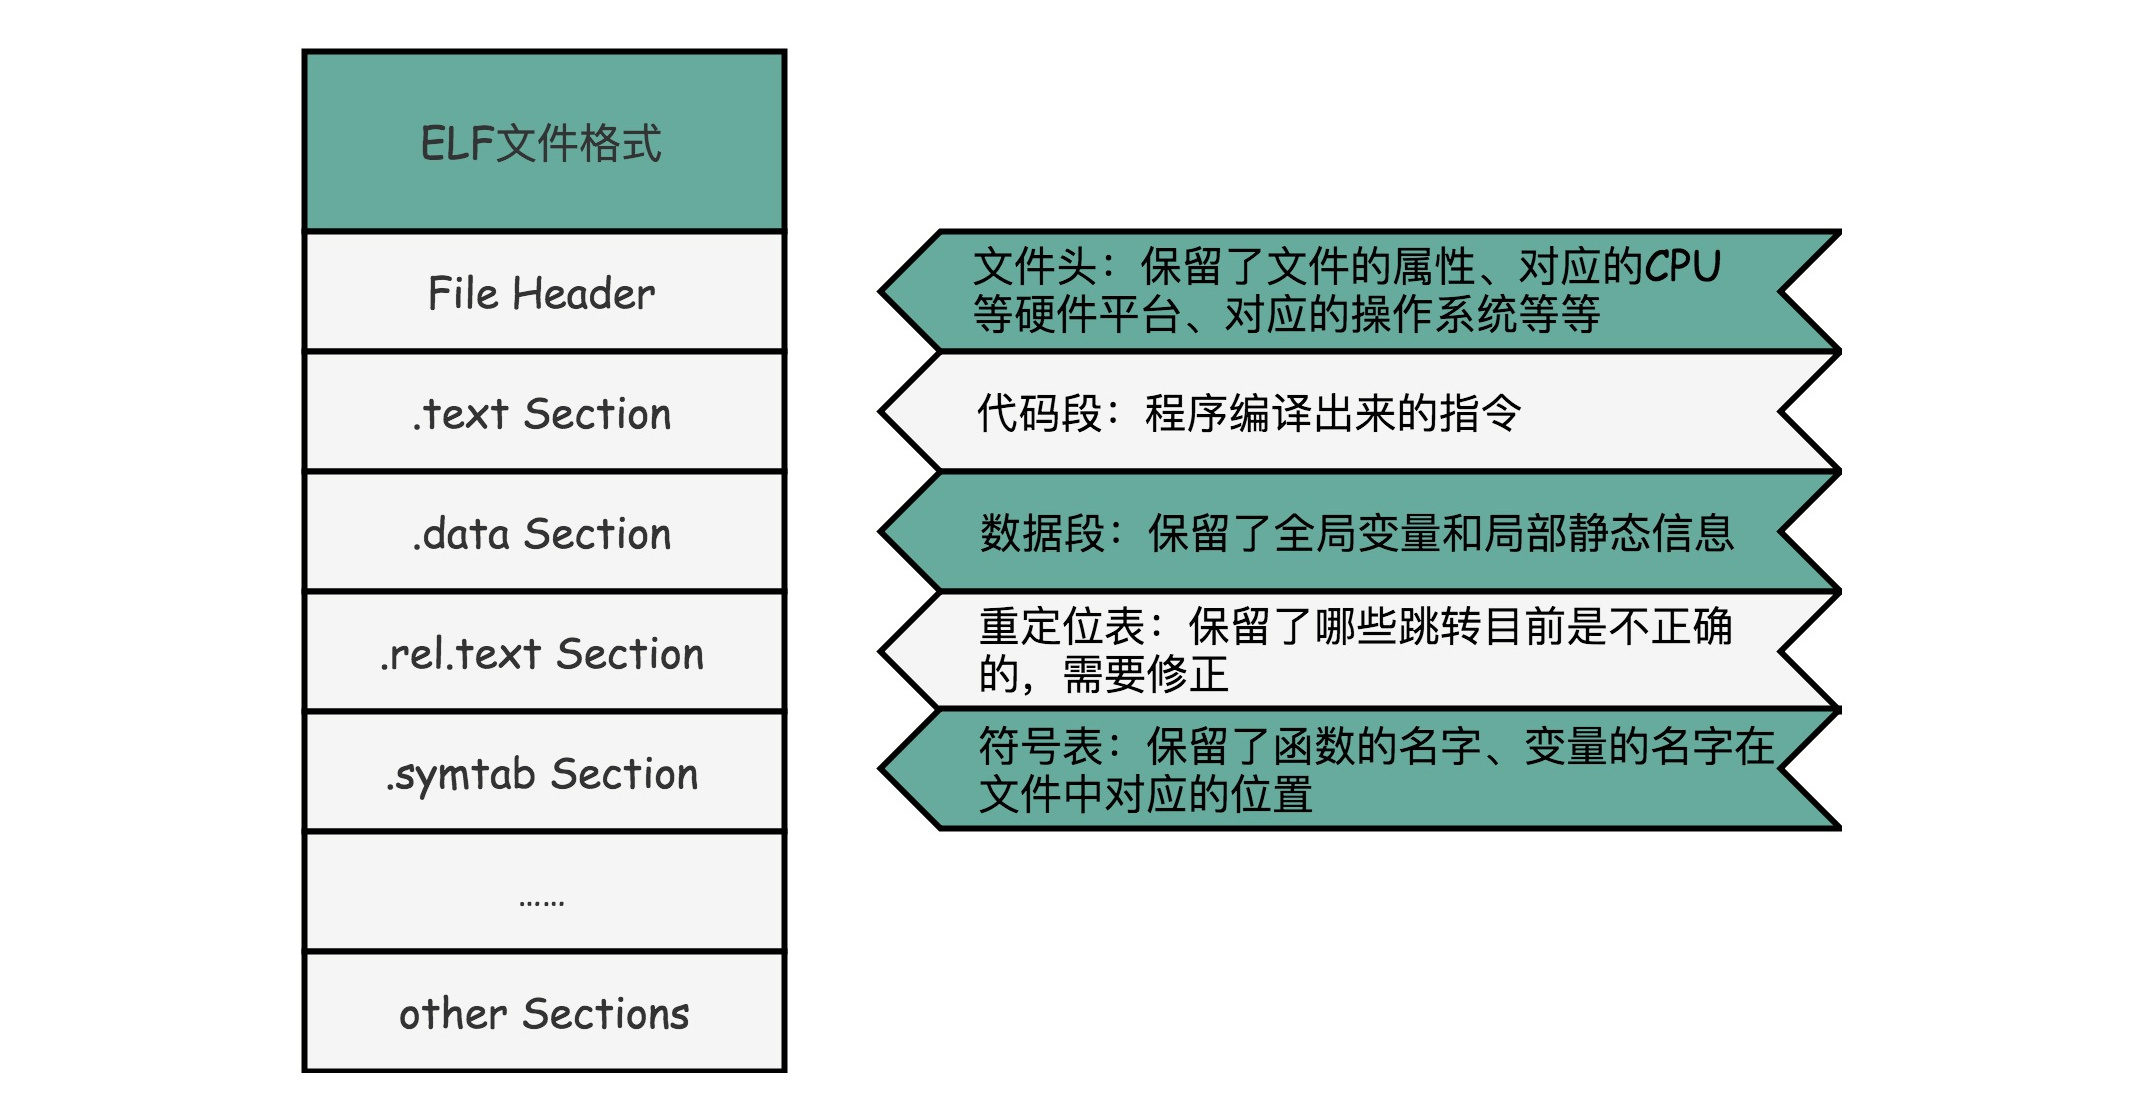
ELF(Execuatable and Linkable File Format)可执行与可链接文件格式
linux中可执行文件和目标文件都用的ELF(Execuatable and Linkable File Format)
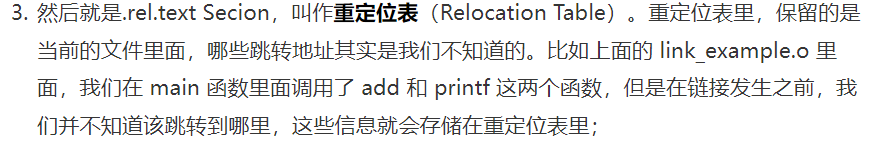
.re.text section(重定位表)
重定位表保留的是当前文件里哪些函数的跳转地址是不确定的比如printf以及其他自定义函数,在链接发生前
是不知道要跳转到哪里的地址,这些不确定跳转地址就保存在重定位表里
.symtab section(符号表)
符号表保存的是函数名和对应地址;也就是一个地址簿
链接阶段
链接器会扫描目标文件然后把符号表里的信息收集起来如printf以及其他自定义等函数的名称和地址构成一个全局的符号表;
比如目前环境下有两个目标文件
在链接前在函数内调用其他函数会指向下一条指令而不是被调用函数的入口
在连接时链接器扫描所有所以目标文件,构成一个全局符号表,再将重定位表根据全局符号表进行修正,合并
最终变为可执行文件
程序装载
==运行可执行文件时就是通过一个装载器,解析 ELF 或者 PE 格式的可执行文件,然后将指令和数据加载到内存里面让CPU去执行==
程序装载面临的挑战
1.可执行程序加载后占用的内存应该是连续的
2.因为在同一时刻要同时运行多个程序,所以不能让程序按照自己在内存中规定的位置加载;(程序自己规定的内存位置可能会被其他正在运行的程序占用);
为了要满足这两个要求我们需要固定分配一段连续的空间给程序,所有程序所看到内存地址都是一样的;将这段连续的内存空间与原本程序指定的物理内存做一个映射;就解决了一个程序执行过程中可能不连续的情况同时也解决了可能被占用的情况;
分配的这一段连续的空间就是虚拟内存
我们把指令里用到的内存地址叫作虚拟内存地址(Virtual Memory Address),实际在内存硬件里面的空间地址,我们叫物理内存地址(Physical Memory Address)。
**Virtual memory is an abstraction that provides each process with the illusion that it has exclusive use of the main memory. Each process has the same uniform view of memory, which is known as its virtual address space. ** --CSAPP
内存分段
这种找出一段连续的物理内存和虚拟内存地址进行映射的方法,叫做分段,这里的段就是系统分配出的一段连续的内存空间
系统分配出的一段连续的内存空间,
内存分段会造成内存碎片(Memory Fragmentation)的问题
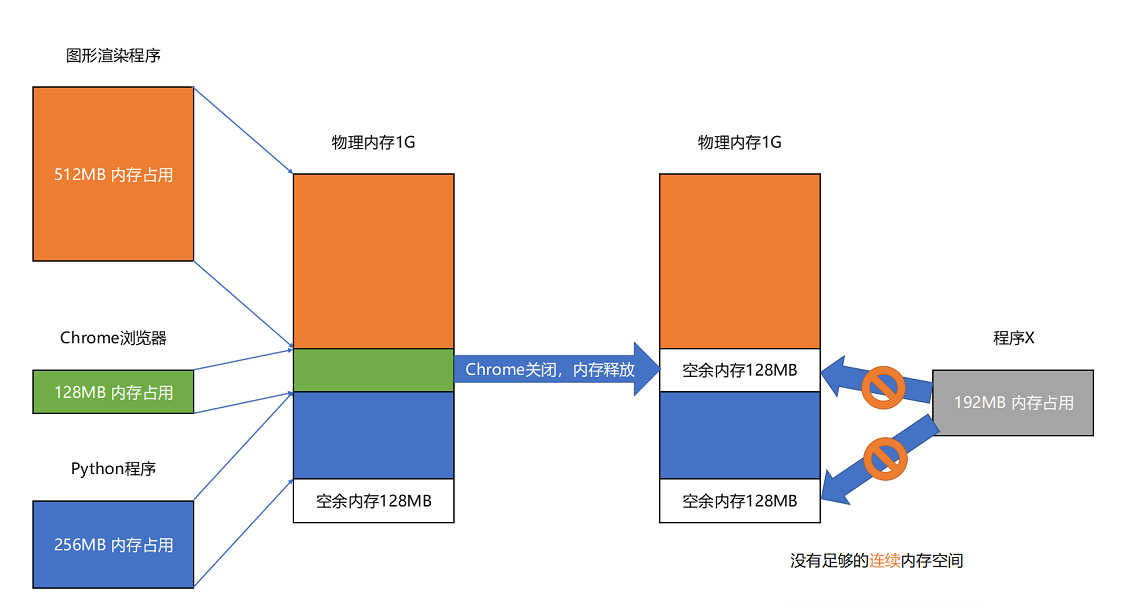
解决的这个问题可以用内存交换来解决我们可以把 Python 程序占用的那 256MB 内存写到硬盘上,然后再从硬盘上读回来到内存里面。不过读回来的时候,我们不再把它加载到原来的位置,而是紧紧跟在那已经被占用了的 512MB 内存后面,同过这样的方式实现内存交换来解决内存碎片;
虚拟内存、分段,再加上内存交换,看起来似乎已经解决了计算机同时装载运行很多个程序的问题。不过,你千万不要大意,这三者的组合仍然会遇到一个性能瓶颈。硬盘的访问速度要比内存慢很多,而每一次内存交换,我们都需要把一大段连续的内存数据写到硬盘上。所以,如果内存交换的时候,交换的是一个很占内存空间的程序,这样整个机器都会显得卡顿。
现在问题出在内存碎片和内存交换空间太大上我们通过内存分页的方式来解决这两个问题;内存分页和分段这样分配一整段连续的空间给到程序相比,内存分页是把整个物理内存空间切成一段段固定尺寸的大小(一般为4KB),而对应的程序所需要占用的虚拟内存空间,也会同样切成一段段固定尺寸的大小,这个固定尺寸大小的空间就是页,从虚拟内存到物理内存的映射,不再是拿整段连续的内存的物理地址,而是按照一个一个页来的。页的尺寸一般远远小于整个程序的大小,由于内存空间都是预先划分好的,也就没有了不能使用的碎片,而只有被释放出来的很多 4KB 的页。即使内存空间不够,需要让现有的、正在运行的其他程序,通过内存交换释放出一些内存的页出来,一次性写入磁盘的也只有少数的一个页或者几个页,不会花太多时间,让整个机器被内存交换的过程给卡住。
程序是怎样跑起来的
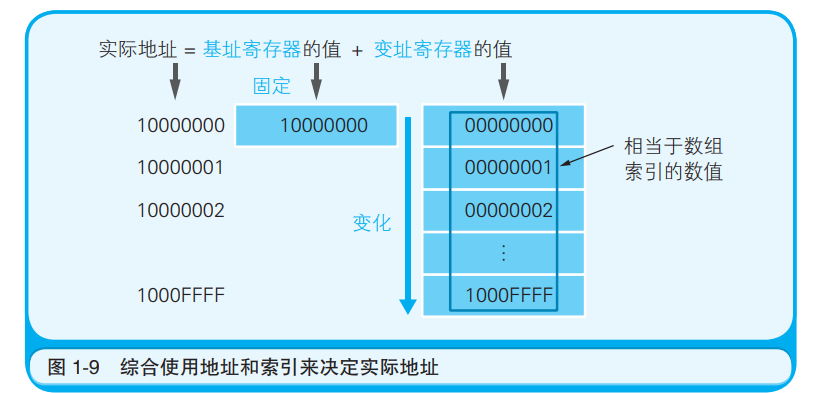
1.6通过地址和索引实现数组
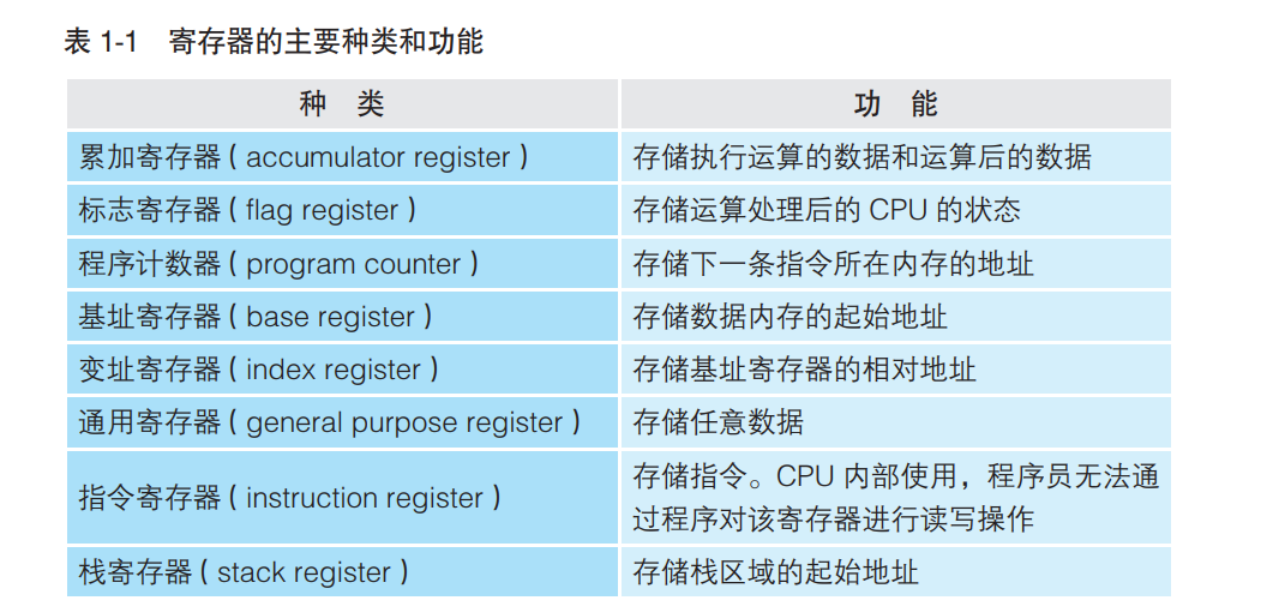
实现数组要用到两个寄存器
一个是基址寄存器:存储数组的内存起始地址
一个是变址寄存器:存储的类似索引的东西
实际地址=基址寄存器的值+变址寄存器的值
2.2二进制转换为十进制
就是各数位的数值和位权相乘后再相加的数值
位权
○○的 ×× 次幂”表示位权
其中○○再十进制中是10二进制中是2
××在任何进制中都是数的位数-1,第一位就是1-1=0次幂,第二位就是2-1=1次幂;
在小数中,小数点后一位的××是-1;后二位是-2以此类推,

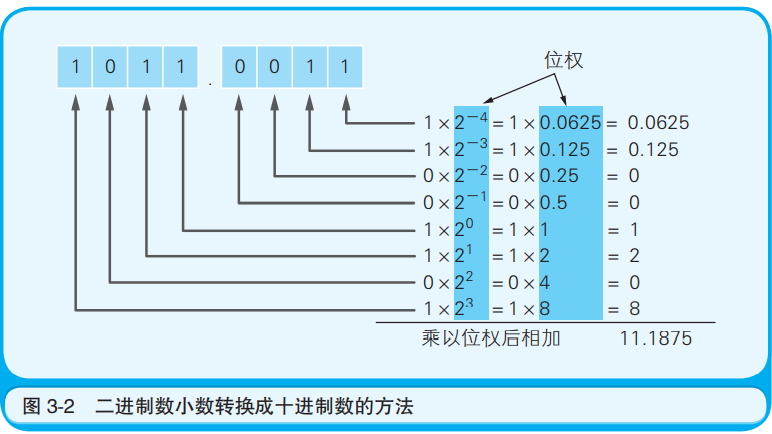
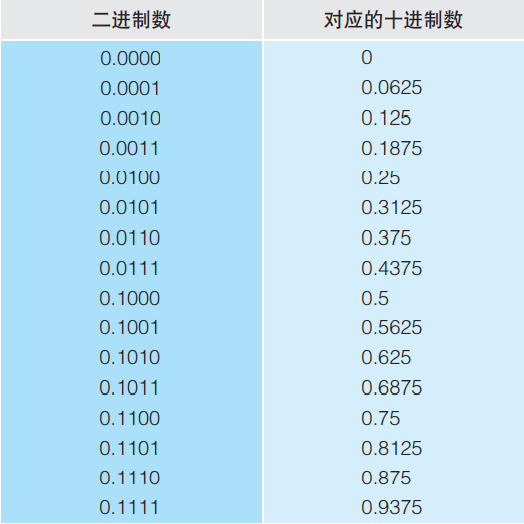
按照计算机存储小数的方式可以看到并不是所有的十进制小数都能被表示;这就会造成计算机进行小数运算时的错误
3.4浮点数
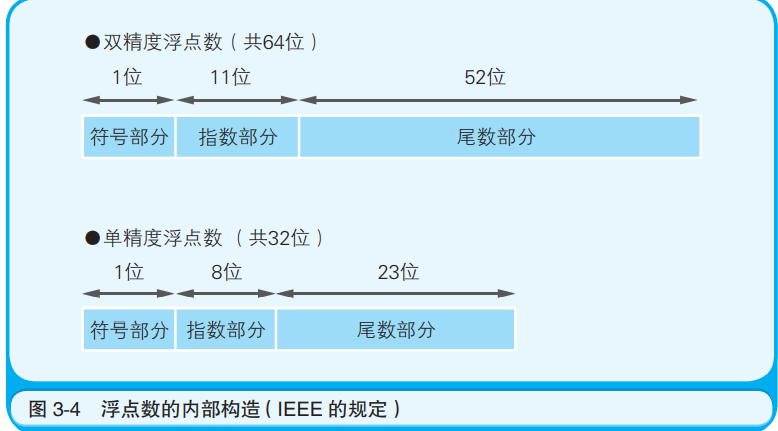
浮点数就是符号,尾数,基数和指数这四个部分来表示的小数
符号位根据小数的正负情况决定
尾数依据一个正则表达式
基数在二进制中就是二
指数用excess系统决定
尾数部分使用正则表达式,因为浮点数又各种表现形式,所以要指定一个统一的规则
这个规则就是将二进制中小数点前面的部分固定为1;也就是需要通过移位的方式将二进制数左移或者右移
使其整数部分第一位变为1,第二位及以后都为0;

指数部分用的史excess系统简单来说就是将指数部分-127得出的值就是真正的指数;
数组中的链表
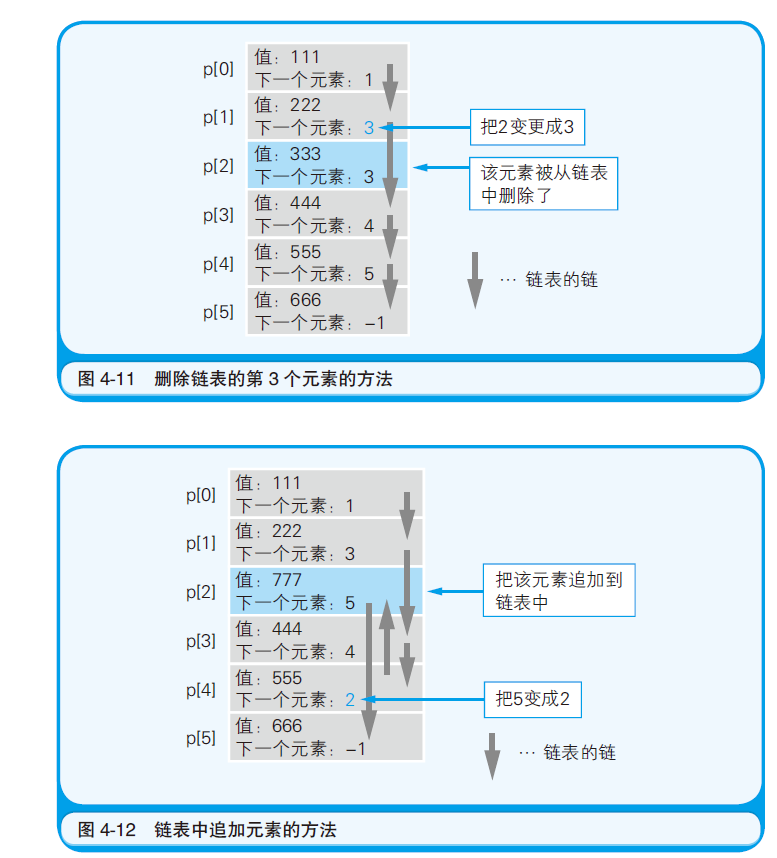
链表即在数组中的每个元素不仅保存的本身的值还保存的去往下个元素的索引,下一个元素也同样存储的下一个元素的索引直到最后的元素由于不存在下一个元素的索引所以存储索引的是-1;链表的作用在于增删操作
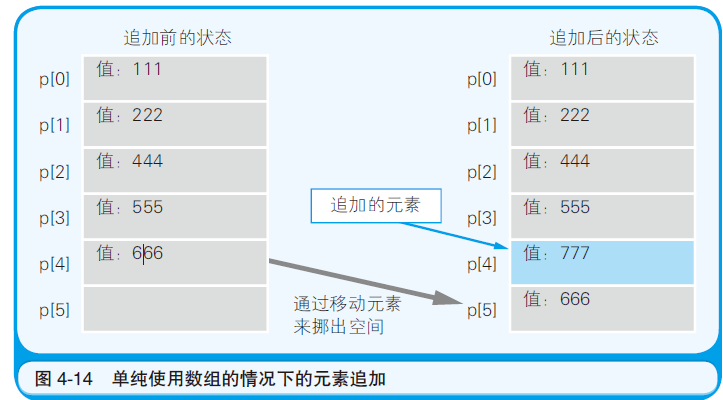
对于数组元素的的增加与删除
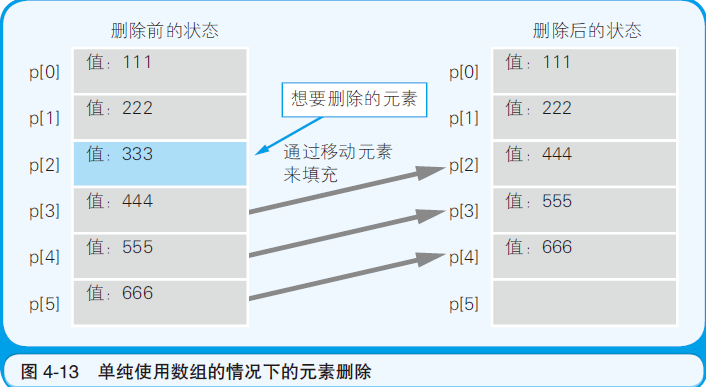
不使用链表时对数组进行删除和新增操作
从数组其中一个位置中删除元素会造成后面所有的元素进行移动
使用链表的增删操作
删除时将要删除的索引的上一个元素的索引索引设置为下下个元素的索引这样就跳过了要删除的索引,这是逻辑上的删除,这个元素还是存在于这个数组中,
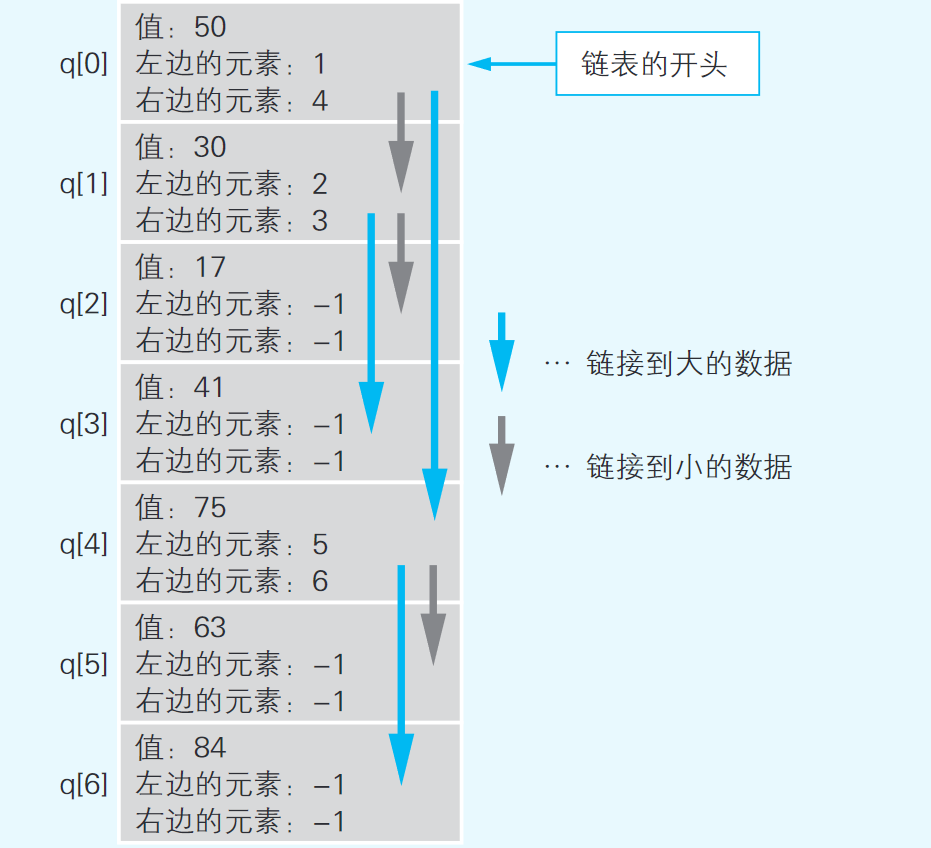
数组中的二叉查找树
二叉查找树是在逻辑上对于要存储的数据进行一个比较,同过比较大小来将数据从逻辑上分为两个方向(大向右,小向左),这样在检索上就方便很多,只需要在检索是比较大小即可,如果比现在元素大就向右查找,如果小就向做查找;
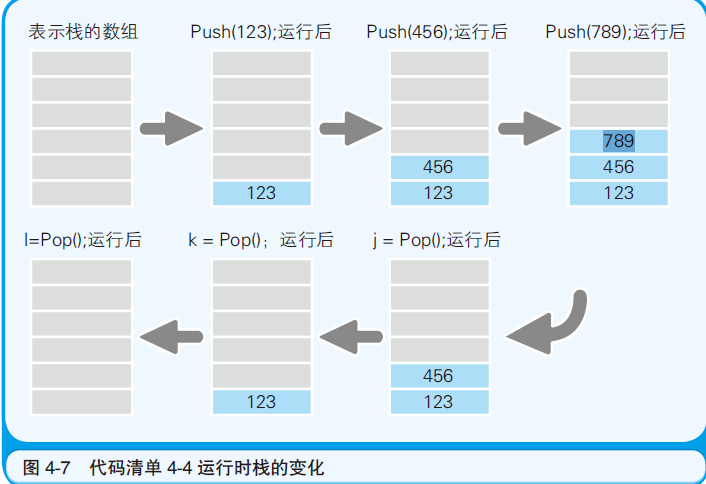
栈
栈是一种遵循后进先出(last input first out)的一种数据存储方式
浏览器的回退功能就是栈的一种实现
在浏览器浏览页面时,我们先打开页面a然后跳转到页面b,然后从页面b跳转到页面c;这时我们想要回到页面a,我们使用回退时先退到页面b,再从页面b回退到页面a;在这个过程中关闭页面a就是将页面a入栈,关闭页面b时,将页面b入栈,回退时,先看到页面b,在回退看到页面
队列
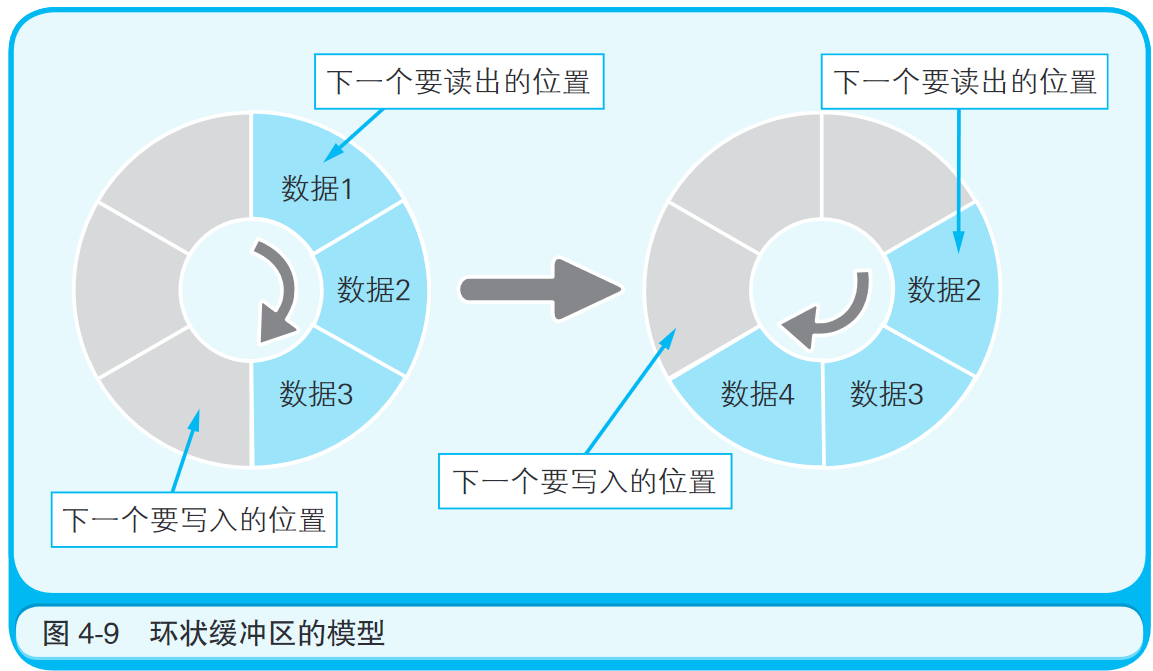
与栈相反,队列才用的是First input first out(FIFO)的方式来存储数据,
类似于买票时第一个买票的人第一个走
队列的实现是用一种方式叫做:环形缓冲区(ring buffer);假设要用六个元素来实现一个队列,这样队列的头尾相连,输入和输出就可以循环起来
磁盘
扇区:扇区是读写磁盘的最小单位
磁道:围绕扇区划分的同心圆就是磁道;一个磁盘可能由多个盘这些盘的磁道上下对齐看到的就是一个柱面;
簇:计算机在软件层面读取磁盘的单位是簇;一个簇就是一组或者一个扇区;磁盘容量越大簇包含的扇区个数就越大;
压缩
摩尔斯电号
哈夫曼编码
哈夫曼编码为各个不同的文件构造不同的编码,对文件中出现频率高的用少位数的编码,出现频率低的用多位数的编码
运行环境
程序的运行环境=操作系统+硬件,不同的cpu架构有不同的操作系统,即使在同样的cpu架构下也由不同的操作系统,而软件就是在一个特定的硬件和特定的操作系统下才能运行;
cpu之外的硬件
在windows之前的系统上面的软件都会有一部分直接操作硬件不同过操作系统,这就导致不同机型有不同内存和i/o设备所以不同的机型要有其特定的软件;而windows上面的软件操作硬件都是通过windows系统间接就行操作,所以只要cpu的架构相同,windows上的软件可以任何机型上运行;
不同的操作系统
在同样cpu架构下不同的操作系统之所以不能通用软件是因为不同的操作系统API(Application programming interface)不同
系统调用
系统调用就是调用系统的函数(API)控制硬件的行为,高级语言在编写过程中只需要用自己的函数,在编译后变为操作系统所使用的函数来控制硬件;
API
API(Application programming interface) 应用程序编程接口;API是一组函数,用来和硬件沟通,每个函数都有它控制硬件实现的功能
高级语言在编写时只需要用自己定义的函数在编译后对应到操作系统用来操作系统的函数,这些函数就是API
操作系统的这些函数时有应用对应从而操作硬件的,所以叫做应用程序接口
比如C语言中fopen()这个高级语言函数的作用是打开一个文件,在底层来看看非常复杂,打开文件首先要扫描硬盘,找到文件的位置,然后从文件中读取一部分数据,将数据放进I/O缓冲区,放进内存;这些数据都是0、1序列,还要对照ASCII表或Unicode表”翻译“成字符,再在显示器上显示出来。将这个过程编写为一个函数,我们只需要调用函数就能实现相应的操作
设备驱动
设备驱动是操作系统的一部分,提供硬件同操作系统进行基本输入输出的功能,没有驱动程序,就无法与硬件沟通
API和驱动程序
操作系统理论研究者有时把操作系统分成四大部分:
驱动程序:最底层的、直接控制和监视各类硬件的部分,它们的职责是隐藏硬件的具体细节,并向其他部分提供一个抽象的、通用的接口。
内核:操作系统内核部分,通常运行在最高特权级,负责提供基础性、结构性的功能。
接口库:是一系列特殊的程序库,它们职责在于把系统所提供的基本服务包装成应用程序所能够使用的编程接口(API),是最靠近应用程序的部分。例如,GNU C运行期库就属于此类,它把各种操作系统的内部编程接口包装成ANSI C和POSIX编程接口的形式。
外围:是指操作系统中除以上三类以外的所有其他部分,通常是用于提供特定高级服务的部件。例如,在微内核结构中,大部分系统服务,以及UNIX/Linux中各种守护进程都通常被划归此列。
api需要的函数也需要通过设备驱动来进行控制硬件
api靠近应用,设备驱动靠近硬件
BIOS和引导程序
引导程序是在磁盘开始位置的一个小程序,作用是将操作系统os放到内存中去运行
BIOS会在计算机启动后检查硬件是否正常运行,如果正常运行就启动引导程序;
为什么一个应用不能在所有操作系统上通用
因为每个操作系统的api不同;对用应用来说api是应用调用操作系统的手段,也被称为系统调用;对于操作系统来说api是操作系统的一些已经写好的函数用来控制硬件,不同操作系统上的软件关于调用api的部分不同;
程序运行阶段会产写两个额外的组:栈和堆; 栈是用来存储函数内部临时使用的变量(局部变量),以及函数调用时所用的参数的内存区域。 堆是用来存储程序运行时的任意数据及对象的内存领域
栈和堆不同的地方在于栈在程序运行时自动分配空间,结束后自动释放,而堆是通过程序员自己分配和释放,在c语言中,malloc()函数用于分配堆空间,free()函数用于释放空间,
汇编语言
汇编语言是二进制代码的助记符,这些由助记符组成的语言就叫汇编语言,所以汇编语言和本地的二进制代码是一一对应的.
编码
字符集是一个系统支持的所有抽象字符的集合,就是各种符号文字的总成,比如ASCII字符集.
字符编码是怎么把字符集里的这些字符一一用二进制表示的一个字典,比如ASCII字符编码.
Unicode 字符集,就可以用 UTF-8、UTF-16 等多种字符编码来表示
每一种字符编码最好的描述方式就是简单粗暴的一个字典,或者说一张表,比如 ASCII,没什么可解释的,它就是一张表。编码就从右往左看,解码就从左往右看。详见附录 ASCII
所以出现乱码就是因为解码时用错了字符编码,当时编码时用的上面字符编码,解码时也应该使用上面字符编码
Unicode
Unicode 本身并没有规定一个字符究竟是怎么编码,甚至都没有规定用几个字节表示,所以也叫可变长度字符编码。Unicode 只规定了每个字符对应到唯一的代码值(code point),代码值从 0000~10FFFF 共 1114112 个值,你曾经看到的很讨人厌的 \u0300 这种,就是 Unicode 的代码值,这种代码值要想变成真正存储在机器里的字符串,一定要进行某种编码,如下。
ustr = \u0030;  例如字符'A' 在unicode对应一个唯一的代码值,然后具体在用某个字符编码进行编码
str = ustr.encode("utf-8")
中文占几个字节
那基于各种历史的或者是合理性原因,人们把占用 1 个字节的给了 ASCII;占 2 个字节的给了拉丁文、希腊文、西里尔字母、亚美尼亚语、希伯来文等;占 3 个字节的给了大部分汉字,基本等同于 GBK,含 21000 多个汉字;占 4 个字节的中日韩超大字符集里面的汉字,有 5 万多个。Unicode 字符集中的大部分汉字,如果用 UTF-8 编码的话,是占 3 个字节的。而 UTF-8 编码本身,是 1~4 个字节的可变长度字符编码。